A replicação de dados mantém cópias atualizadas das informações em servidores distintos, ajudando empresas a sustentar serviços quando há falhas e a distribuir consultas de leitura. Para gestores de TI, a decisão não é simplesmente adicionar servidores: é equilibrar disponibilidade, desempenho, consistência e custo com as necessidades reais de cada sistema.
Uma arquitetura bem planejada define quais dados replicar, com que atraso aceitável e como agir quando o servidor principal falhar. Sem esses critérios, as cópias podem aumentar a complexidade sem resolver o gargalo que afeta a operação.
O que decidir antes de implantar réplicas
- Disponibilidade: qual tempo de interrupção o negócio consegue tolerar?
- Perda de dados: qual intervalo de alterações seria aceitável perder numa falha?
- Desempenho: o limite está nas consultas de leitura, nas gravações ou na rede?
- Custo total: a equipe consegue operar, monitorar e testar a arquitetura?
Essas respostas orientam a quantidade e a localização das réplicas, o modo de sincronização e o investimento necessário. Replicação não é uma garantia automática de continuidade: é um componente de uma estratégia que também precisa de monitoramento, procedimentos de recuperação e testes.
Como funciona uma arquitetura com servidor principal e réplicas
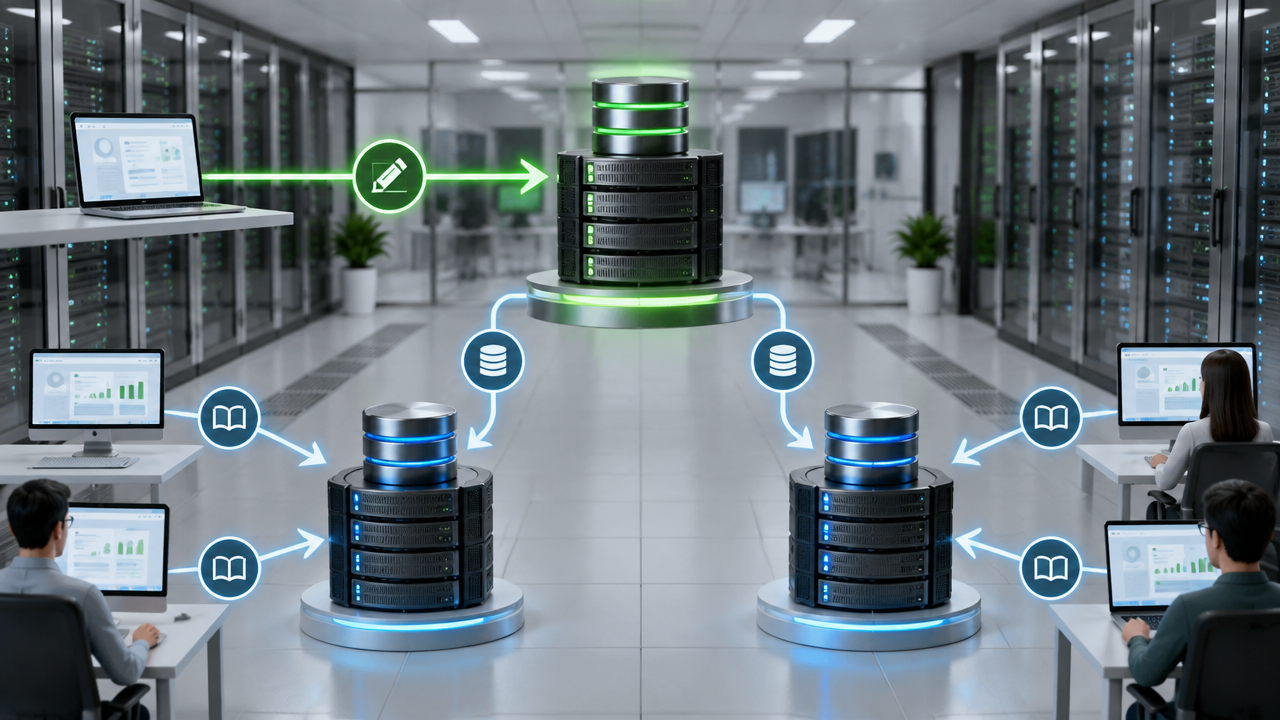
Em um modelo comum, o servidor principal recebe as gravações e envia as alterações para outros servidores, chamados réplicas. Elas podem atender consultas de leitura ou ficar preparadas para assumir o serviço se o principal falhar. No PostgreSQL, por exemplo, um servidor em modo de espera pode aceitar consultas somente de leitura, enquanto acompanha as alterações recebidas do principal.
Imagine um sistema corporativo de vendas: a atualização de um pedido é gravada no principal, enquanto consultas de relatórios ou de histórico podem ser direcionadas às réplicas. Se a aplicação precisa mostrar imediatamente uma alteração recém-gravada, deve considerar o possível atraso de sincronização e, quando necessário, consultar o principal.
Quando as réplicas ajudam e quando não resolvem o problema
Réplicas são mais úteis quando há muitas leituras, necessidade de recuperação rápida ou usuários distribuídos geograficamente. Separar algumas consultas do servidor principal pode reduzir a concorrência por recursos e aproximar a leitura de quem usa o sistema, desde que a aplicação tolere eventuais dados desatualizados.
Elas não aceleram automaticamente todas as operações. Se o problema for uma consulta ineficiente, índices ausentes, contenção nas gravações ou código que gera chamadas excessivas, adicionar réplicas pode apenas aumentar a conta. Antes de expandir a infraestrutura, identifique o gargalo com métricas de banco, aplicação e rede.
- Considere primeiro otimizar consultas e índices quando o gargalo é localizado.
- Avalie cache para leituras repetidas que aceitam regras próprias de atualização.
- Adote réplicas quando houver uma necessidade mensurável de escala de leitura ou continuidade.
Sincronização síncrona, assíncrona e semissíncrona
O modo de sincronização define a relação entre velocidade de confirmação e proteção das alterações recentes. Na replicação síncrona, a gravação aguarda uma confirmação configurada da réplica, o que pode elevar a latência, especialmente quando os servidores estão distantes. A documentação do PostgreSQL descreve essa espera e o custo de desempenho associado.
| Modo | Vantagem | Trade-off |
|---|---|---|
| Síncrono | Maior proteção das transações confirmadas na configuração adotada | A gravação pode esperar pela rede e pela réplica |
| Assíncrono | Confirma gravações sem aguardar a réplica | Pode haver atraso e perda das mudanças ainda não copiadas |
| Semissíncrono | Busca um compromisso entre confirmação e latência | Comportamento e garantias dependem do produto e da configuração |
A replicação assíncrona pode deixar consultas temporariamente desatualizadas e, após uma falha, existe risco para transações ainda não recebidas pela réplica. A síncrona reduz esse risco conforme a configuração, mas introduz espera nas gravações. Não existe um modo ideal para todo sistema: a escolha deve refletir os requisitos do serviço.
Como controlar atraso, consistência e failover
O atraso de replicação, ou replication lag, é o intervalo entre uma mudança no principal e sua aplicação em uma réplica. Se ele cresce, usuários podem consultar dados antigos e uma réplica pode estar menos preparada para assumir o serviço. Monitore atraso, conectividade, volume de alterações e capacidade de armazenamento, com alertas ligados ao impacto operacional.
Failover é a transferência do papel principal para uma réplica escolhida. Para que funcione, não basta ter a cópia: é preciso detectar a falha, promover o servidor correto, redirecionar conexões e evitar que o antigo principal volte a aceitar gravações simultaneamente. A documentação do PostgreSQL observa que a detecção e a notificação de falhas precisam ser tratadas por componentes externos ao próprio banco.
Documente responsáveis, critérios de promoção, comunicação e retorno à configuração normal. Exercícios controlados ajudam a verificar se os objetivos de recuperação definidos pela empresa são realistas.
Como estimar o custo sem comprar capacidade desnecessária
Cada réplica pode exigir computação, armazenamento, licenças e tráfego de rede. Some também o esforço de administração, monitoramento, testes de failover e suporte. Se os servidores estiverem em locais diferentes, considere a capacidade da conexão e o efeito da distância nas gravações síncronas.
Compare o custo da arquitetura com o benefício esperado: redução de interrupções, melhor resposta nas consultas ou menor exposição a falhas localizadas. Uma réplica de leitura, uma réplica de contingência e um cache resolvem necessidades diferentes, portanto não devem ser tratados como peças intercambiáveis.
Replicação também não substitui backup. Uma exclusão acidental ou alteração maliciosa pode ser copiada para os demais servidores; cópias de segurança com retenção e restauração testada atendem a outro objetivo. A documentação do PostgreSQL distingue a recuperação a partir de um servidor em espera da restauração, que pode levar mais tempo.
Uma decisão de arquitetura alinhada à operação
Comece pelos serviços mais críticos, meça o padrão de leitura e gravação e estabeleça limites aceitáveis de interrupção e perda de dados. Depois, valide a estratégia em testes, incluindo atraso, queda de rede e promoção de uma réplica. Assim, a infraestrutura cresce de acordo com requisitos observáveis, em vez de pressupostos.
A Telway Solutions pode apoiar empresas na avaliação da infraestrutura, da continuidade operacional e dos custos envolvidos. Uma consultoria inicial gratuita ajuda a identificar gargalos e desenhar uma arquitetura adequada ao cenário de cada organização.
Perguntas frequentes
O que é replicação de dados?
Replicação de dados é o processo de manter cópias atualizadas das mesmas informações em servidores diferentes. Em uma arquitetura comum, um servidor principal recebe as gravações e transmite as alterações para réplicas, que podem atender consultas de leitura ou assumir operações se o principal falhar.
Como a replicação melhora a disponibilidade e o desempenho?
Ela pode aumentar a disponibilidade porque uma réplica preparada pode assumir o serviço se o servidor principal ficar indisponível. Também pode melhorar o tempo de resposta ao atender leituras em servidores próximos ou menos carregados. O resultado depende da configuração, da latência da rede e de como a aplicação distribui as consultas.
Qual é a diferença entre replicação síncrona e assíncrona?
Na replicação síncrona, uma gravação aguarda a confirmação de uma ou mais réplicas, o que reduz a possibilidade de perder transações confirmadas, mas pode elevar a latência. Na assíncrona, o principal confirma antes de a cópia terminar, favorecendo a velocidade, com risco de atraso ou perda das mudanças mais recentes numa falha.
Replicação substitui backup?
Não. A replicação mantém cópias operacionais e pode apoiar a continuidade do serviço, mas exclusões, corrupção e alterações maliciosas também podem chegar às réplicas. O backup preserva pontos de recuperação independentes, conforme sua política de retenção. Para resiliência, use as duas estratégias e teste a restauração.
Como monitorar o atraso das réplicas e preparar o failover?
Acompanhe o atraso entre a gravação no principal e sua aplicação nas réplicas, além da conectividade, espaço disponível, taxa de alterações e estado do processo de sincronização. Defina limites de alerta ligados ao impacto no negócio e teste o failover. Métricas e procedimentos variam conforme a tecnologia adotada.